Wprowadzenie do sfederowanego uczenia maszynowego
Jak wytrenować model na danych, których nigdy nie można skopiować — praktyczne wprowadzenie do uczenia sfederowanego z Flower AI i TensorFlow.
Budując własne modele uczenia maszynowego — klasyfikatory obrazów, systemy rekomendacji czy gadatliwe modele GPT — szybko natrafisz na typowe problemy: brak danych do nauki albo odwrotnie, brak mocy obliczeniowej przy nadmiarze danych, do tego kwestie prywatności i system, który nie skaluje się razem z treningiem.
Wraz z rosnącym wykorzystaniem urządzeń mobilnych i IoT ogromne ilości danych znajdują się na urządzeniach użytkowników albo w zasobach prywatnych firm. Mogłyby być świetnym źródłem do trenowania modelu, ale w wielu przypadkach po prostu nie wolno ich skopiować do własnego magazynu. Istnieje jednak sposób, by wytrenować model bez przenoszenia danych na swoje dyski. Tu wkracza sfederowane uczenie maszynowe.
Czym jest sfederowane uczenie maszynowe?
W internecie znajdziemy kilka ciekawych definicji (cytujemy je w oryginale).
Federated learning (also known as collaborative learning) is a sub-field of machine learning focusing on settings in which multiple entities (often referred to as clients) collaboratively train a model while ensuring that their data remains decentralized. [1]
In federated optimization, the devices are used as compute nodes performing computation on their local data in order to update a global model. (…) Additionally, since different users generate data with different patterns, it is reasonable to assume that no device has a representative sample of the overall distribution. [2]
Federated learning is a way to train AI models without anyone seeing or touching your data, offering a way to unlock information to feed new AI applications. [3]
Te trzy cytaty dobrze oddają istotę uczenia sfederowanego. Nauka nie odbywa się już na jednej centralnej maszynie. Każdy klient trenuje własną wersję globalnego modelu, a częściowe modele są potem łączone z powrotem w jeden model globalny.
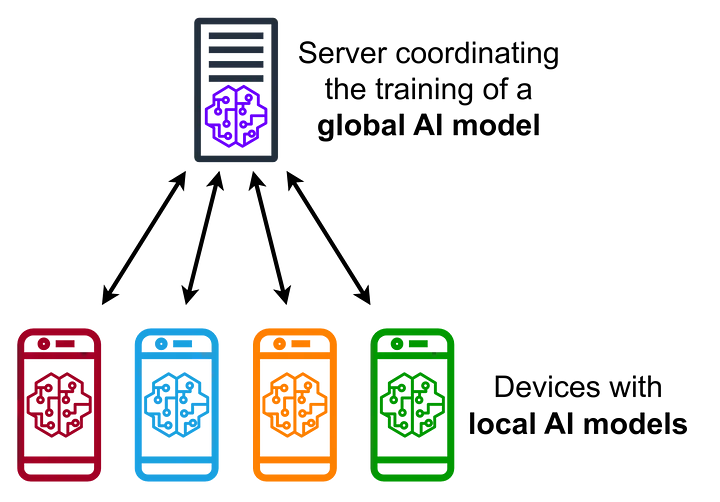
Możesz się zastanawiać: skoro każdy klient trenuje własny model lokalny, jak powstaje jeden model końcowy? Jest kilka sposobów łączenia modeli lokalnych, ale na początek najpewniej spotkasz się z metodą zwaną uśrednianiem sfederowanym (federated averaging).
W tym podejściu serwer wysyła wagi (nazywane też parametrami) do grupy wybranych klientów. Wagi mogą pochodzić z modelu wstępnie wytrenowanego na niewielkiej próbce Twoich danych albo być na starcie zupełnie losowe. Każdy klient odbudowuje model lokalny z tymi wagami, krótko trenuje go na własnych danych i odsyła nowe wagi. Gdy serwer zbierze je wszystkie, liczy średnią ważoną, tworzy nowe wagi globalne, rozsyła je ponownie do klientów, a cały proces powtarza się kilka razy, aż powstanie model końcowy.
Mając ogólny obraz działania, możemy zbudować przykład. Żeby ułatwić sobie życie, nie będziemy implementować wszystkiego sami — skorzystamy z jednego z frameworków do uczenia sfederowanego: Flower AI.
Czym jest Flower AI?
Flower AI określa się jako ujednolicone podejście do sfederowanego uczenia, analityki i ewaluacji, które federuje dowolne zadania, z dowolnym frameworkiem ML i w dowolnym języku programowania. Niezależnie od tego, czy wolisz PyTorch, TensorFlow, JAX czy fastai — wybór należy do Ciebie. Przy tym rozwiązuje kluczowe problemy: prywatność danych, ich rozproszenie geograficzne oraz urządzenia o ograniczonej mocy, takie jak smartfony czy urządzenia IoT.
Jest elastyczny, skalowalny i nie narusza prywatnych danych. Flower AI ma gotowe projekty startowe i szczegółową dokumentację wielu zastosowań — więcej znajdziesz na flower.ai.
Co zbudujemy?
Zbudujemy „hello world” uczenia maszynowego — klasyfikator obrazów, a konkretnie odręcznie pisanych liter. Będziemy mieć trzech klientów, każdy z około 250 próbkami w dziesięciu klasach (litery od A do J). Jako framework ML wykorzystamy TensorFlow, a do federacji treningu — Flower AI. W tym przykładzie serwer i klienci działają lokalnie, ale równie dobrze mogłyby komunikować się przez sieć.
Aby budować razem z nami, zainstaluj następujące pakiety:
pip install flwr tensorflow matplotlib scikit-learnBudowa modelu
Jeśli masz doświadczenie z TensorFlow, nic Cię tu nie zaskoczy. Zaczynamy od dość typowej sieci konwolucyjnej, często używanej do klasyfikacji obrazów.
def get_model() -> keras.Model:
    model = keras.Sequential([
        keras.layers.Input(shape=(100, 100, 1)),
        keras.layers.Conv2D(8, 5, activation='relu', kernel_initializer='variance_scaling'),
        keras.layers.MaxPooling2D(strides=(2, 2)),
        keras.layers.Conv2D(16, 3, activation='relu', kernel_initializer='variance_scaling'),
        keras.layers.Flatten(),
        keras.layers.Dense(units=10, activation='softmax', kernel_initializer='variance_scaling')
    ])

    model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])

    return model
To nie jest najbardziej zaawansowana sieć konwolucyjna, jaką widziałeś, ale do demonstracji sprawdza się bardzo dobrze — zostańmy przy niej.
Aplikacja serwerowa
Teraz potrzebujemy serwera, który zorkiestruje trening — i tu właśnie wkracza Flower AI. Pozwala wybrać strategię uczenia. Wybierzemy jedną z najpopularniejszych strategii agregacji sfederowanej i lekko ją dostosujemy.
Po pierwsze, po każdej rundzie treningu chcemy wypisać bieżącą dokładność. Osiągniemy to, rozszerzając aggregate_evaluate i korzystając z metryk wysłanych przez klientów. Po drugie, model ma być zapisywany po każdej rundzie — w tym celu rozszerzamy aggregate_fit i zapisujemy bieżący model we wskazanym miejscu.
class CustomStrategy(fl.server.strategy.FedAvg):
    def aggregate_evaluate(self, server_round: int, results: List[Tuple[ClientProxy, EvaluateRes]], failures: List[Union[Tuple[ClientProxy, EvaluateRes], BaseException]]) -> Tuple[Optional[float], Dict[str, Scalar]]:
        if not results:
            return None, {}

        loss, metrics = super().aggregate_evaluate(server_round, results, failures)
        accuracies = [r.metrics["accuracy"] * r.num_examples for _, r in results]
        examples = [r.num_examples for _, r in results]

        accuracy = sum(accuracies) / sum(examples)
        log(INFO, f"Round {server_round} accuracy aggregated from {len(results)} clients: {accuracy}")

        return loss, {"accuracy": accuracy}

    def aggregate_fit(self, server_round: int, results: List[Tuple[ClientProxy, FitRes]], failures: List[Union[Tuple[ClientProxy, FitRes], BaseException]]) -> Tuple[Optional[Parameters], Dict[str, Scalar]]:
        parameters, metrics = super().aggregate_fit(server_round, results, failures)

        if parameters is not None:
            model = get_model()
            model.set_weights(fl.common.parameters_to_ndarrays(parameters))
            model.save(f"models/model-round-{server_round}.keras")
            log(INFO, f"Saving round {server_round} model")

        return parameters, metrics
Następnie przygotowujemy serwer: definiujemy jego adres i liczbę rund treningu. Oba parametry przekażemy jako argumenty wiersza poleceń przy uruchamianiu skryptu.
def main(server_address: str, num_rounds: int) -> None:
    fl.server.start_server(
        server_address=server_address,
        config=fl.server.ServerConfig(num_rounds=num_rounds),
        strategy=CustomStrategy(min_available_clients=3, min_fit_clients=3, min_evaluate_clients=3),
    )


if __name__ == "__main__":
    parser = argparse.ArgumentParser(description='Server')
    parser.add_argument('--server-address', type=str, required=True)
    parser.add_argument('--num-rounds', type=int, required=True)
    args = parser.parse_args()

    main(server_address=args.server_address, num_rounds=args.num_rounds)
Dla dokładniejszego wglądu w trening możemy narysować, jak zmieniają się dokładność i strata w kolejnych rundach. start_server zwraca obiekt historii, z którego zbudujemy wykres.
def plot(history: fl.server.history.History) -> None:
    accuracy = history.metrics_distributed["accuracy"]
    accuracy_index = [data[0] for data in accuracy]
    accuracy_value = [100.0 * data[1] for data in accuracy]

    loss = history.losses_distributed
    loss_index = [data[0] for data in loss]
    loss_value = [data[1] for data in loss]

    plt.plot(accuracy_index, accuracy_value, "r-", label="Accuracy")
    plt.plot(loss_index, loss_value, "b-", label="Loss")
    plt.grid()
    plt.xlabel("Round")
    plt.ylabel("Accuracy (%)")
    plt.title("Handwritten Letters Classifier - Federated Accuracy")
    plt.show()


def main(server_address: str, num_rounds: int) -> None:
    history = fl.server.start_server(...)
    plot(history)
Aplikacja kliencka
Gdy serwer jest gotowy, budujemy klienta. Rozszerzamy NumPyClient z Flower AI i implementujemy get_parameters, fit oraz evaluate.
get_parameters zwraca wagi bieżącego modelu. fit trenuje model i zwraca krotkę z nowymi wagami, rozmiarem zbioru treningowego (potrzebnym do średniej ważonej na serwerze) i interesującymi nas metrykami. evaluate sprawdza postępy modelu i zwraca stratę, rozmiar zbioru walidacyjnego oraz metryki, które chcemy przekazać serwerowi.
class Client(fl.client.NumPyClient):
    def __init__(self, model: keras.Model, trainset: tf.data.Dataset, validset: tf.data.Dataset):
        self.model = model
        self.trainset = trainset
        self.validset = validset

    def get_parameters(self, config: Dict[str, Scalar]) -> NDArrays:
        return self.model.get_weights()

    def fit(self, parameters: NDArrays, config: Dict[str, Scalar]) -> Tuple[NDArrays, int, Dict[str, Scalar]]:
        self.model.set_weights(parameters)
        self.model.fit(self.trainset, epochs=1, batch_size=32)
        return self.model.get_weights(), len(self.trainset), {}

    def evaluate(self, parameters: NDArrays, config: Dict[str, Scalar]) -> Tuple[float, int, Dict[str, Scalar]]:
        self.model.set_weights(parameters)
        loss, accuracy = self.model.evaluate(self.validset)
        return loss, len(self.validset), {"accuracy": accuracy}
Następnie wczytujemy dane. Funkcja image_dataset_from_directory z Keras podzieli je na zbiór treningowy i walidacyjny. Nasze obrazy mają 100×100 px i są czarno-białe, więc wczytujemy je w skali szarości, pomijając zbędne kanały kolorów.
def get_datasets(data_dir: str) -> tf.data.Dataset:
    datasets = keras.utils.image_dataset_from_directory(
        directory=data_dir,
        validation_split=0.1,
        subset="both",
        color_mode="grayscale",
        image_size=(100, 100),
        shuffle=True,
        batch_size=32,
        seed=522437,
    )
    return datasets
Teraz możemy uruchomić klienta. Potrzebuje adresu serwera i ścieżki do swoich danych, które w tym przykładzie leżą w podkatalogu na dysku lokalnym.
def main(server_address: str, data_dir: str) -> None:
    trainset, validset = get_datasets(data_dir)
    model = get_model()

    fl.client.start_numpy_client(
        server_address=server_address,
        client=Client(model, trainset, validset)
    )


if __name__ == "__main__":
    parser = argparse.ArgumentParser(description='Client')
    parser.add_argument('--server-address', type=str, required=True)
    parser.add_argument('--data-dir', type=str, required=True)
    args = parser.parse_args()

    main(server_address=args.server_address, data_dir=args.data_dir)
Zaczynamy trening
Gdy obie aplikacje są gotowe, uruchamiamy je w osobnych sesjach terminala. Potrzebujemy jednego serwera i trzech klientów, a serwer musi wystartować pierwszy.
python server.py --server-address=0.0.0.0:8080 --num-rounds=6
python client.py --server-address=127.0.0.1:8080 --data-dir=./data/client-1
python client.py --server-address=127.0.0.1:8080 --data-dir=./data/client-2
python client.py --server-address=127.0.0.1:8080 --data-dir=./data/client-3
Zobaczysz dość szczegółowy log z postępami nauki, udanymi i nieudanymi sesjami, dokładnością i stratą. Na koniec pojawi się wykres: czerwona linia to dokładność, a niebieska — strata w kolejnych rundach.
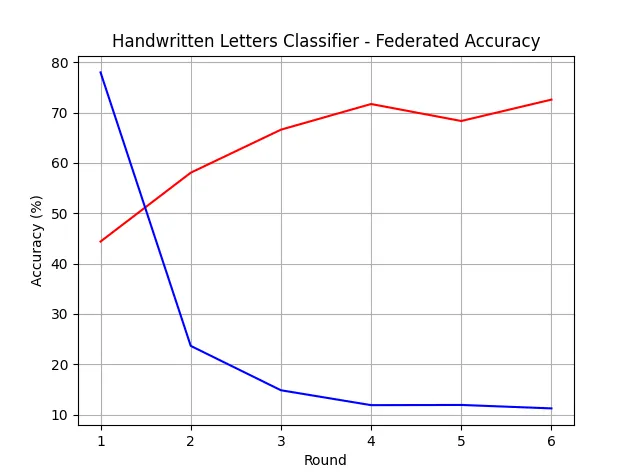
Dzięki naszej strategii model jest też zapisywany po każdej rundzie w katalogu models. Możemy go wypróbować na odręcznych literach — poniższy skrypt wczytuje model i przewiduje literę na wskazanym obrazie.
class_names = ['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h', 'i', 'j']


def main(model_path: str, image_path: str) -> None:
    model = keras.models.load_model(model_path)

    image = keras.utils.load_img(image_path, target_size=(100, 100), color_mode="grayscale")
    image = keras.utils.img_to_array(image)
    image = tf.expand_dims(image, 0)

    prediction = model.predict(image)
    score = tf.nn.softmax(prediction[0])

    print(
        "This image most likely belongs to {} with a {:.2f} percent confidence."
        .format(class_names[np.argmax(score)], 100 * np.max(score))
    )


if __name__ == "__main__":
    parser = argparse.ArgumentParser(description='Validator')
    parser.add_argument('--model-path', type=str, required=True)
    parser.add_argument('--image-path', type=str, required=True)
    args = parser.parse_args()

    main(args.model_path, args.image_path)
Uruchom go poleceniem:
python predict.py --image-path=./data/client-2/g/1691660116597.png --model-path=./models/model-round-6.kerasW wyniku zobaczysz: This image most likely belongs to ’g’ with a 23.20 percent confidence. Pewność nie jest wysoka, ale litera została rozpoznana poprawnie.
Na koniec macierz pomyłek pokaże wyraźniej, jak model radzi sobie z poszczególnymi klasami. Wygenerujemy ją poniższym kodem.
class_names = ['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h', 'i', 'j']


def get_test_data(data_dir: str) -> Tuple[np.ndarray, np.ndarray]:
    dataset = keras.utils.image_dataset_from_directory(
        directory=data_dir,
        color_mode="grayscale",
        image_size=(100, 100),
        shuffle=True,
        batch_size=32,
        seed=522437,
    )
    test_images, test_labels = zip(*dataset.unbatch().as_numpy_iterator())
    test_images = np.array(test_images)
    test_labels = np.array(test_labels)

    return test_images, test_labels


def main(model_path: str, data_dir: str) -> None:
    model = keras.models.load_model(model_path)
    test_images, test_labels = get_test_data(data_dir)

    predictions = model.predict(test_images)
    predicted_labels = np.argmax(predictions, axis=1)

    matrix = confusion_matrix(test_labels, predicted_labels, labels=range(10))
    display = ConfusionMatrixDisplay(confusion_matrix=matrix, display_labels=[s[-1] for s in class_names])
    display.plot(cmap=plt.cm.Blues, values_format='.4g')

    plt.show()


if __name__ == "__main__":
    parser = argparse.ArgumentParser(description='Validator')
    parser.add_argument('--model-path', type=str, required=True)
    parser.add_argument('--data-dir', type=str, required=True)
    args = parser.parse_args()

    main(args.model_path, args.data_dir)
Uruchom go poleceniem:
python confusion.py --model-path=./models/model-round-6.keras --data-dir=./data/client-2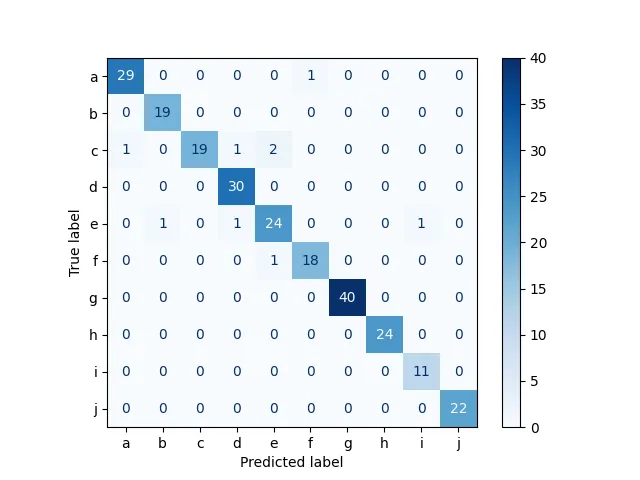
Pamiętaj, że wynik nie jest w pełni miarodajny, bo dane ewaluacyjne pokrywają się z treningowymi — ale do demonstracji wystarczy :)
Podsumowanie
Sfederowane uczenie maszynowe jest bardziej złożone od scentralizowanego, ale otwiera możliwości, które inaczej byłyby poza zasięgiem — zwłaszcza gdy prywatność danych lub ich rozproszenie geograficzne są twardymi ograniczeniami. Warto je rozważyć zawsze wtedy, gdy dane nie mogą przyjść do modelu.